
Source: The Conversation – in French – By Cécile Pierrot, Chargée de recherche en cryptographie, Inria
L’ESSENTIEL
-
Depuis septembre, des internautes annoncent avoir déchiffré des centaines de textes anciens avec ChatGPT ou Claude.
-
Presque aucun résultat n’est vérifié et plusieurs sont erronés ou déjà connus.
-
Même si ces déchiffrements étaient justes, la recherche ne se limite pas à produire en masse des résultats plausibles sans vérification ni objectif.
Les formulations ne manquent pas d’emphase. « 90 191 années de silence ont pris fin », peut-on lire sur un blog, qui fait la somme des années d’oubli de chacun des documents concernés. Un autre, sur X, invite à « résoudre des mystères inédits, vieux de plusieurs siècles ». Depuis la mi-septembre, la scène se rejoue, inlassablement : un internaute annonce sur les réseaux sociaux qu’il a percé le secret d’un texte resté jusqu’alors inviolé. En raison de son chiffrement – un processus d’écriture permettant de rendre un message incompréhensible pour quiconque n’en aurait pas la clé –, les informations contenues dans le document et désormais révélées au public viendraient résoudre les mystères insolubles de l’Histoire.
Bien que les résultats publiés annoncent des déchiffrements, nul cryptographe n’intervient dans ces prétendus exploits. Ces « déchiffreurs » ne sont pas non plus historiens ou linguistes. Au contraire, ils délèguent l’ensemble des étapes du processus de déchiffrement à une intelligence artificielle générative, Claude ou ChatGPT en tête, et ne s’appuient sur aucune expertise scientifique, ni pour identifier les documents nécessitant réellement un déchiffrement, ni pour les transcrire, ni pour les déchiffrer. Surtout, ils semblent accorder une confiance démesurée aux IA génératives sans se soucier des données moissonnées par celles-ci pour répondre à la requête, des potentielles hallucinations ou, plus largement, de l’opacité de leur fonctionnement.
En l’espace de quelques semaines seulement, 200 à 300 déchiffrements ont été revendiqués, et ce, pour un large panel de documents, du XVᵉ au XXᵉ siècle, relatifs à la France, à l’Espagne, à l’Angleterre, à l’Allemagne… Au premier regard, les résultats paraissent époustouflants. Quelques centaines de dollars pour un abonnement à une intelligence artificielle générative et quelques heures de travail suffiraient à chaque fois pour casser un chiffre.
En tant qu’expertes du domaine, nous aimerions nous réjouir de ce qui aurait pu permettre de réelles avancées pour la cryptographie historique et plus largement pour la recherche en histoire, et ce, d’autant plus que, depuis près d’une décennie déjà, l’intelligence artificielle a été identifiée comme l’un des leviers pour déchiffrer les documents historiques. Cependant, à y regarder de plus près, les résultats obtenus par l’intermédiaire de Claude ou de ChatGPT ne contribuent que peu aux progrès de la connaissance, voire la mettent en danger.
Le coût de la vérification
Si nous ne parvenons pas à nous réjouir, c’est que, pour l’heure, presque rien n’a été vérifié scientifiquement. Grâce à la puissance de calcul déployée par l’IA générative, il suffit parfois de quelques minutes pour se voir proposer une première solution de déchiffrement plausible. Cependant, sans vérification humaine et surtout sans vérification scientifique, ces solutions n’ont aucune valeur et pourraient tout aussi bien être de séduisantes hallucinations.
Or, la vérification linguistique, historique et cryptographique de chaque solution peut prendre des jours, ou même des semaines, y compris pour des chercheurs experts. Celle-ci nécessite de passer en revue l’intégralité de la transcription du texte chiffré, symbole par symbole, puis de croiser le déchiffrement obtenu avec les données historiques, archivistiques et linguistiques existantes.
Seule une solution univoque, en tout point conforme au contexte historique, et pouvant être reproduite de manière indépendante en dehors de l’environnement des IA génératives commerciales peut être considérée comme valide scientifiquement et donc comme pouvant être mise à disposition du public.
Malheureusement, la facilité (et la rapidité) à obtenir des solutions plausibles produit une abondance de résultats qu’il est humainement impossible de valider sérieusement, a fortiori dans la temporalité resserrée qu’impliquent ces déchiffrements incessants. L’examen minutieux, indispensable à la rigueur et à la validation scientifiques, risque ainsi d’accaparer les forces vives de nos disciplines et de détourner les chercheurs de travaux de fond, pourtant indispensables à l’établissement d’une histoire de la cryptographie fiable et documentée… que les IA génératives utiliseront parfois pour produire de nouveaux déchiffrements !
Plus encore, cette pratique nous pose un véritable problème d’éthique. Nous sommes sans cesse sollicitées par ces internautes en quête de validation, comme par les médias qui nous demandent de nous prononcer sur ces résultats. Plusieurs demandes nous sont adressées chaque semaine, portant souvent sur une poignée de documents ; or, la vérification scientifique d’un seul résultat requiert en moyenne deux journées de travail.
À lire aussi :
Ces détectives qui traquent les fraudes scientifiques : conversation avec Guillaume Cabanac
La solution de facilité serait d’ignorer ces sollicitations et ces nouveaux « déchiffrements ». Néanmoins, non seulement nous ne concevons pas la recherche comme repliée sur elle-même et ignorant toute contribution qui serait obtenue hors du cadre institutionnel de l’enseignement supérieur et de la recherche ; mais surtout nous ne pouvons pas ignorer l’existence de ces résultats.
Le travail scientifique repose en effet, contrairement à ce que pratiquent ces internautes, sur l’identification de toutes les ressources liées à un sujet et sur le croisement des précédentes études. Nous ne pouvons pas écarter une proposition de lecture tant qu’elle n’a pas été formellement invalidée.
De ce fait, les chercheurs devraient consacrer un temps considérable à examiner des travaux qu’ils n’ont pas sollicités, qu’ils ne pourront probablement pas exploiter, même indirectement (car incomplets, fautifs et/ou insuffisamment documentés), qui ne répondent à aucune méthodologie et qui ont été produits non par des humains, mais par des outils dont les auteurs eux-mêmes n’ont pas la maîtrise technique. Enfin, la forte visibilité et la fréquence de ces « déchiffrements » tendent à invisibiliser, à dévaloriser voire à remettre en cause le temps long de la recherche, pourtant meilleure garantie de résultats fiables et exploitables.
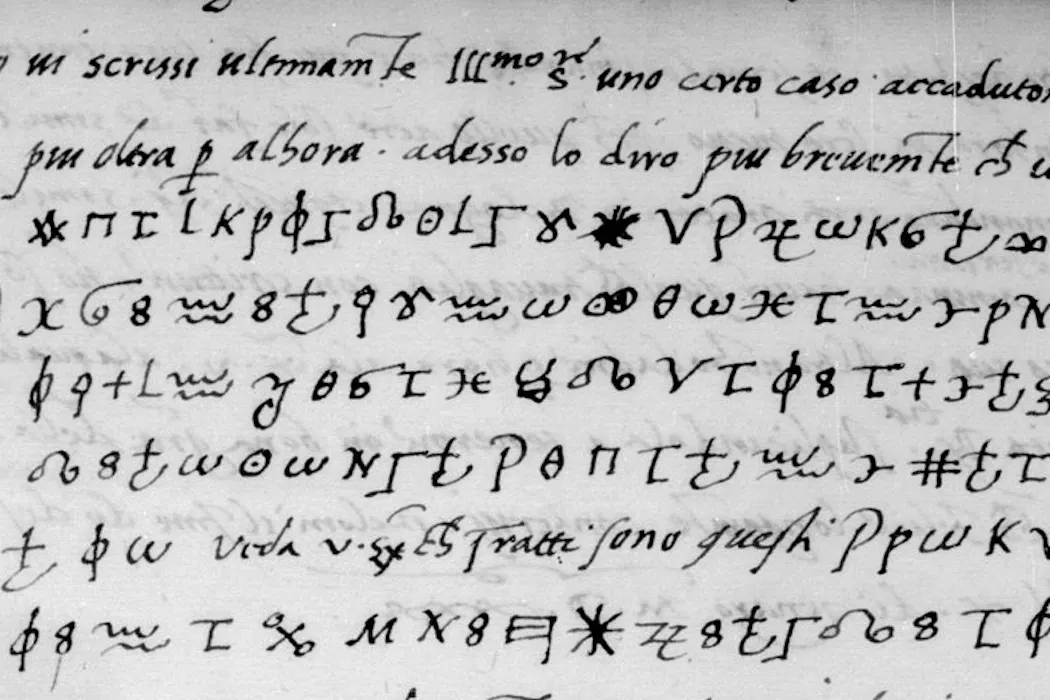
À cette difficulté de masse s’ajoute la qualité très variable des résultats annoncés. Un premier examen de certains déchiffrements par nos soins montre des erreurs fondamentales à plusieurs niveaux. La transformation d’un document manuscrit chiffré en une transcription numérique produit parfois des incohérences.
De même, la version déchiffrée brute peut elle aussi différer de la version finalement annoncée. Des éléments ont disparu, d’autres ont été modifiés, sans qu’aucune de ces aberrations (voire hallucinations) ne soit justifiée ou même relevée. La difficulté à lire et à comprendre les annexes fournies (constituées le plus souvent de simples données brutes produites par l’IA) est amplifiée par un vocabulaire souvent inadapté et par l’emploi de formulations qui confinent à l’absurde : que comprendre quand l’IA nous dit, par exemple, qu’elle a terminé le déchiffrement « à la main » ?

Autrices, Fourni par l’auteur
Nous voici face à une incohérence majeure : l’IA générative dont on vante la capacité à nous faire gagner du temps finit par nous faire perdre nos journées, et ce, sans faire progresser nos connaissances.
Des résultats, mais quelles découvertes ?
Au-delà de leur véracité, qu’apprenons-nous de ces centaines de résultats ? Des « mystères » ont-ils réellement été dévoilés ? Une nouvelle méthode de cryptanalyse, c’est-à-dire de déchiffrement à partir du texte chiffré seulement, a-t-elle été découverte ? Rien de tout ceci.
L’un des premiers déchiffrements réalisés par IA à avoir fait parler de lui (un message transmettant des ordres de Napoléon), ne nous a rien appris. Plus encore, le contenu d’une partie des documents présentés comme « déchiffrés » était déjà accessible aux chercheurs comme au public ; certains avaient même déjà fait l’objet de déchiffrements (sans IA !).
Au-delà d’une course erronée à la nouveauté et au sensationnel, de telles publications tendent à invisibiliser voire à discréditer le travail mené par les chercheurs, notamment en histoire et en cryptographie historique. Notre travail est certes plus long, moins tapageur, mais contribue durablement à la connaissance des sociétés anciennes et de leur histoire tandis que l’évaluation entre pairs permet aux résultats d’être immédiatement validés scientifiquement sans requérir des expertises gratuites et quasi sisyphéennes.
Sur le plan technologique par ailleurs, il n’a pas encore été démontré que des chiffrements historiques considérés comme insolubles pouvaient désormais être déchiffrés par l’IA de manière systématique, fiable et reproductible. Plus largement, quelle valeur accorder en effet à un outil, certes producteur d’apparentes solutions, mais dont on ne peut vérifier ni le résultat ni le processus ayant mené à ce résultat ?
Dans certains cas, l’IA ne fait guère plus que trouver des clefs ou des déchiffrements déjà existants en ligne. Sans nier ni même sous-estimer le potentiel d’avancées technologiques portés par l’intelligence artificielle en matière de déchiffrements historiques, l’usage qui est actuellement fait des assistants d’IA générative va à l’encontre des principes même de la science.
À rebours de la démarche scientifique
Il ne s’agit nullement d’opposer amateurs et experts, ni de refuser tout changement dans nos pratiques, méthodes ou outils. Néanmoins, rendre accessible ne veut cependant pas dire « mettre en ligne », mais « donner sens à ». Là est le sens même de la science ouverte que nous défendons, au bénéfice de la société, mais sans sacrifier à l’indispensable rigueur nécessaire aux avancées scientifiques.
Ce n’est pas non plus une prise de position radicale contre l’IA, loin de là : elle est intégrée à nos projets de recherche depuis plusieurs années. Mais nous développons un modèle d’IA, conforme à l’intégrité scientifique. Gratuit, il est consacré à une tâche spécifique (la transcription de documents chiffrés), construit sur une expertise interdisciplinaire, utilisé sous contrôle et produisant des résultats systématiquement vérifiés et reproductibles dans d’autres environnements. Elle ne dispose certes pas de la force de frappe des grandes compagnies états-uniennes qui développent des modèles de langue (LLM) conçus pour produire un texte probable quelle que soit la question posée, mais elle est développée de manière éthique, libre et ouverte.
Pour ces raisons, nous ne pouvons pas nous féliciter de ces « déchiffrements », faits à rebours de toute démarche scientifique et marginalisant à la fois la connaissance historique et l’expertise des cryptographes. Ils tendent à restreindre le champ même de la recherche. Le chercheur ne serait là que pour vérifier à la chaîne les nouvelles solutions, et mettre en lumière grâce à un habillage historique les déchiffrements opérés par des utilisateurs intensifs de l’IA générative.
Or, le travail scientifique va bien au-delà de la seule homologation que viennent chercher ces déchiffreurs. La connaissance ne se construit que dans le cadre d’une démarche réflexive et argumentée, seule garantie contre les manipulations de l’information et autres biais. Malheureusement, conduits de la sorte, ces « déchiffrements » ne fournissent aux chercheurs que des miettes peu digestes, parfois périmées ou mal assorties, dont ils ne connaissent ni la composition ni le fabricant.
Plus encore, en acceptant de valider ces solutions, les chercheurs légitimeraient une démarche qui contourne les règles mêmes de la recherche. La science ne consiste pas à produire en masse des résultats plausibles pour laisser ensuite des spécialistes trier, corriger ou homologuer. Elle repose sur des méthodes explicites, des connaissances sourcées et des résultats documentés, reproductibles et évalués par les pairs. Cette démarche a fait ses preuves et n’a cessé de s’adapter aux évolutions culturelles, scientifiques et technologiques pour continuer à garantir des résultats intègres et fiables.
Ici, les méthodes employées restent opaques ; l’héritage scientifique et les travaux précédents sont invisibilisés (car non mentionnés et/ou non mobilisés) ; la méthodologie n’est ni vérifiable ni reproductible (car présentée de manière incomplète, aléatoire et non structurée) ; l’évaluation scientifique (c’est-à-dire le processus de validation des résultats par les pairs) n’a pas été faite ou repose sur le bénévolat d’experts à aucun moment impliqués dans le processus de déchiffrement pour en valider les étapes intermédiaires ou même l’utilité ; le coût financier n’est pas précisé.
Tout ceci ressemble à une expérience de chimie dans laquelle on aurait négligé l’observation, omis de formuler une hypothèse, oublié de concevoir un protocole, délaissé l’interprétation des résultats et passé outre la conclusion : seule l’agitation des substances chimiques est bien présente.
Si ces « déchiffrements » venaient à se poursuivre sous cette forme, le risque est celui d’un appauvrissement de l’histoire et de la cryptographie et, plus largement, celui d’une remise en cause de la démarche scientifique. Comment justifier des mois ou des années de recherche quand son voisin peut « déchiffrer » en quelques heures les documents que nous étudions ? Comment défendre l’apport d’une recherche interdisciplinaire, dans laquelle le déchiffrement ne constitue en réalité qu’une étape, face à cette profusion de résultats faciles ? Comment alerter sur ces résultats non vérifiés mais omniprésents, qui pollueront les moteurs de recherche et peut-être de futures tentatives de déchiffrement ou de vérification ?
La science bute ici sur une difficulté devenue récurrente : indispensable pour bâtir un socle fiable de connaissances, elle peut paraître terne, voire dépassée, face aux promesses chatoyantes de l’IA générative. C’est pourtant en ne renonçant pas à sa rigueur que nous pourrons tirer parti des avancées de l’IA pour faire progresser la connaissance et développer les outils dont nous avons réellement besoin, plutôt que de nous épuiser à réparer les effets de leur usage irréfléchi.

Cécile Pierrot a bénéficié d’un financement public géré par l’Agence nationale de la recherche (ANR) dans le cadre du programme « France 2030 », sous la référence ANR-24-RRII-0002, intitulé « Back In Time », et mis en œuvre par le Programme Quadrant (PIQ) de l’Inria.
Camille Desenclos est membre du Steering Commitee d’HistoCrypt, un réseau international de chercheurs en cryptographie historique, et secrétaire générale adjointe de l’Association des historiens modernistes des universités françaises (AHMUF) .
Depuis 2026, elle bénéficie d’un financement public géré par l’Agence nationale de la recherche (ANR) dans le cadre du programme « France 2030 », sous la référence ANR-24-RRII-0002, intitulé « Back In Time », et mis en œuvre par le Programme Quadrant (PIQ) de l’Inria.
– ref. Des centaines de textes historiques « déchiffrés » par l’IA : que penser de ces résultats ? – https://theconversation.com/des-centaines-de-textes-historiques-dechiffres-par-lia-que-penser-de-ces-resultats-294165
Original source: https://submissions.mil-osi.com/2026/11/10/des-centaines-de-textes-historiques-dechiffres-par-lia-que-penser-de-ces-resultats-294165/