
Source: The Conversation – in French – By Victor Charpenay, Enseignant-chercheur au laboratoire d’informatique, de modélisation et d’optimisation des systèmes (LIMOS), Mines Saint-Etienne – Institut Mines-Télécom
L’ESSENTIEL
-
OpenAI a annoncé avoir résolu un problème mathématique millénaire, consistant à prouver l’existence de solutions uniques aux équations de Navier-Stokes, omniprésentes en mécanique des fluides.
-
L’empreinte carbone de cette preuve mathématique, même si elle est difficile à estimer avec précision, est d’un ordre de grandeur considérable : 1 000 tonnes équivalent CO₂.
-
C’est autant que celle de grands instruments d’observation spatiale, pour des durées d’opérations d’une dizaine d’années. De quoi s’interroger sur l’allocation de telles ressources.
Les annonces successives d’OpenAI au sujet de découvertes scientifiques laissent une impression tenace : l’intelligence artificielle (IA) serait désormais indispensable pour faire de la science.
L’entreprise a d’abord annoncé, début septembre 2026, que sa technologie d’IA générative s’était hissée à la hauteur des grands enjeux scientifiques de notre époque en résolvant l’un des problèmes du Prix du millénaire (Millenium Challenges), proposés par le Clay Institute. Celui-ci consistait à démontrer l’existence de solutions uniques aux équations de Navier-Stokes, omniprésentes en mécanique des fluides.
À lire aussi :
Pourquoi la science des fluides est au cœur des défis du 21e siècle
Elle a ensuite publié, le 6 octobre 2026, plusieurs centaines de preuves mathématiques générées automatiquement, supposées résoudre de nombreux problèmes ouverts en mathématiques. Plus récemment encore, le 26 octobre, elle a annoncé trois nouveaux résultats majeurs en mathématiques, en physique et en informatique, en précisant cette fois comment elle souhaite collaborer avec la communauté scientifique.
Ces trois annonces renforcent l’idée d’une collaboration étroite entre OpenAI et les universités. Il serait même à la portée de chaque scientifique de se faire assister dans ses recherches. Dans son annonce du 6 octobre, l’entreprise dit en effet qu’en moyenne « chaque résultat a nécessité des ressources de calcul équivalentes à environ trois heures de réflexion de ChatGPT Pro », ce qu’une bonne partie du public cible consomme déjà de manière régulière.
Pourtant, les grandes questions théoriques, comme celles portant sur les équations de Navier-Stokes, nécessitent une quantité de calcul bien plus importante. Alors que des critiques émergent sur l’utilité d’une résolution algorithmique de ces questions, on peut aussi s’interroger sur le coût environnemental des services d’OpenAI auprès de la communauté scientifique.
À titre d’exemple, tentons d’estimer l’empreinte carbone du calcul qui a conduit à la découverte d’une solution non triviale aux équations de Navier-Stokes.
L’IA, « bulldozer » pour les mathématiques modernes ?
On pourrait penser que les mathématiques sont la discipline intellectuelle par excellence, qu’il suffit d’un grand tableau blanc et d’un feutre noir pour prouver des théorèmes, inventer de nouveaux formalismes et, finalement, produire de nouvelles connaissances.
Ce n’est plus le cas. La complexité de certaines preuves requiert désormais une assistance informatique. Avec l’émergence des grands modèles de langue (Large Language Models, ou LLM) et des « agents » autonomes, c’est même la part de créativité que suppose la recherche qui peut être automatisée grâce à l’IA.
À force de publier des résultats à la pelle, OpenAI inspire à Robert Hart, journaliste pour le média états-unien The Verge, ainsi qu’à Gaël Varoquaux, chercheur à l’Inria et chroniqueur au Point, l’image d’un bulldozer. Ces deux auteurs en tirent des conclusions légèrement différentes, mais l’analogie est excellente d’un point de vue énergétique : dès ses débuts, il y a dix ans, OpenAI disait avoir à sa disposition 1 600 calculateurs, dont la puissance électrique cumulée était du même ordre de grandeur que celle d’un engin de chantier.

PxHere
Dans sa déclaration de septembre, OpenAI déclare avoir utilisé une dizaine de milliers d’agents pour résoudre ce problème, interagissant les uns avec les autres pendant 88 heures, générant
« 2,7 millions de messages et utilisant environ 130 milliards de “tokens” (jetons de sortie) ».
Au tarif que propose OpenAI, la facture pour ce volume de calcul représente l’équivalent du financement d’une quarantaine de bourses de thèses en France.
Une telle concentration de « réflexion », effectuée en quelques dizaines d’heures là où une thèse nécessite au moins trois ans de travail, implique une consommation électrique considérable. De quoi interroger le coût environnemental réel de l’opération.
À lire aussi :
L’IA générative est-elle soutenable ? Le vrai coût écologique d’un prompt
Comment estimer l’empreinte carbone d’un système d’IA ?
Il faudrait dans l’idéal mener un bilan environnemental multicritères, mais on se limitera ici à un calcul d’empreinte carbone à partir d’une estimation de la consommation électrique. Celle-ci est déjà suffisamment complexe à estimer du fait de l’opacité entretenue par les entreprises de technologie.
Il faut en effet estimer la consommation électrique des LLM avec des informations partielles et beaucoup d’hypothèses : si l’ordre de grandeur obtenu n’est pas bon, OpenAI ne se privera pas de le souligner, comme Google l’a fait ici ou là, en réponse à des publications académiques sur le sujet.
OpenAI, dans son annonce, nous informe qu’il a fallu effectuer 130 milliards d’opérations pour produire une preuve. Une opération consiste en la production d’un token, qui peut représenter une lettre, un mot ou la portion d’un mot.
Par ailleurs, l’entreprise de services Neuralwatt, l’une des rares à fournir ses données de consommation, indique une consommation moyenne de 33,6 kilojoules (kJ) par millier de tokens (soit environ 10 watts-heures) pour le LLM Kimi K3, que l’on peut supposer proche de celui d’OpenAI.
On peut donc estimer l’énergie consommée pour cette preuve à 1,3 gigawatt-heure. Aussi, en 2026 aux États-Unis, la production d’un kilowatt-heure d’électricité génère en moyenne 388 grammes de gaz à effet de serre en équivalent CO₂, ce qui donne, comme ordre de grandeur, une empreinte carbone qui s’approche des 500 tonnes équivalent CO₂.
En 88 heures seulement, le système d’IA d’OpenAI aurait donc émis autant que 50 personnes résidant dans l’Union européenne (UE) pendant un an (pour se nourrir, se loger, se déplacer, etc.).
Un taux d’échec élevé qui alourdit l’empreinte carbone
Lors de sa quête d’une solution aux équations de Navier-Stokes, l’entreprise indique avoir tenté de résoudre d’autres problèmes sans préciser s’ils ont aussi été résolus. Ce n’est probablement pas le cas. On peut donc inclure cette phase exploratoire dans le calcul, de la même manière qu’il faut prendre en compte les échecs dans un processus de recherche.
En conséquence, ce ne sont pas 130 milliards d’opérations qu’il aura fallu mais 300 milliards au total pour trouver un résultat intéressant parmi les problèmes posés. En utilisant les mêmes hypothèses que précédemment, on peut donc considérer qu’il aura fallu émettre plus de 1 000 tonnes équivalent CO₂ pour aboutir à une publication.
On peut espérer que l’ordre de grandeur de cette estimation est correct, mais celle-ci repose sur des hypothèses fragiles :
-
l’énergie d’un calcul dépend moins du nombre de symboles générés que de la durée du calcul ;
-
personne, en dehors du personnel d’OpenAI, ne peut savoir si Kimi K3 est effectivement comparable au modèle d’OpenAI.
Pour autant, les chiffres donnés par Neuralwatt sur d’autres LLM plus petits, comme DeepSeek v4 Flash, sont comparables à ceux que Google et OpenAI consentent à donner à propos de leurs services grand public, soit environ 0,3 watt-heure par requête.
L’empreinte carbone de l’IA face à celle de l’astronomie
On peut formuler les choses de manière plus prudente encore : si une mathématicienne ou un physicien théorique cherchaient à résoudre le problème de singularité posé par les équations de Navier-Stokes sans avoir accès au système d’IA d’OpenAI, elle et il devraient émettre plus de 1 000 tonnes équivalent CO₂, c’est-à-dire multiplier par 100 leur empreinte carbone annuelle (pour l’UE).
Quelle autre activité de recherche s’autorise une telle empreinte ? Une recherche, publiée dans Nature, estimait que l’empreinte carbone de l’infrastructure de recherche en astronomie, grande émettrice de gaz à effet de serre, est comprise entre 22 tonnes et 50 tonnes équivalent CO₂ par astronome (qui s’ajoutent aux 10 tonnes d’équivalent CO₂ moyennes par personne pour l’UE). On est très loin des 1 000 tonnes.
Prenons maintenant l’exemple de grands projets de recherche en astronomie, impliquant des dizaines, voire des centaines de scientifiques. L’organisation Labos 1point5 (en référence à l’objectif de limiter le réchauffement climatique à 1,5 °C) propose une méthodologie pour évaluer l’empreinte carbone d’un laboratoire sur ce type de projets.
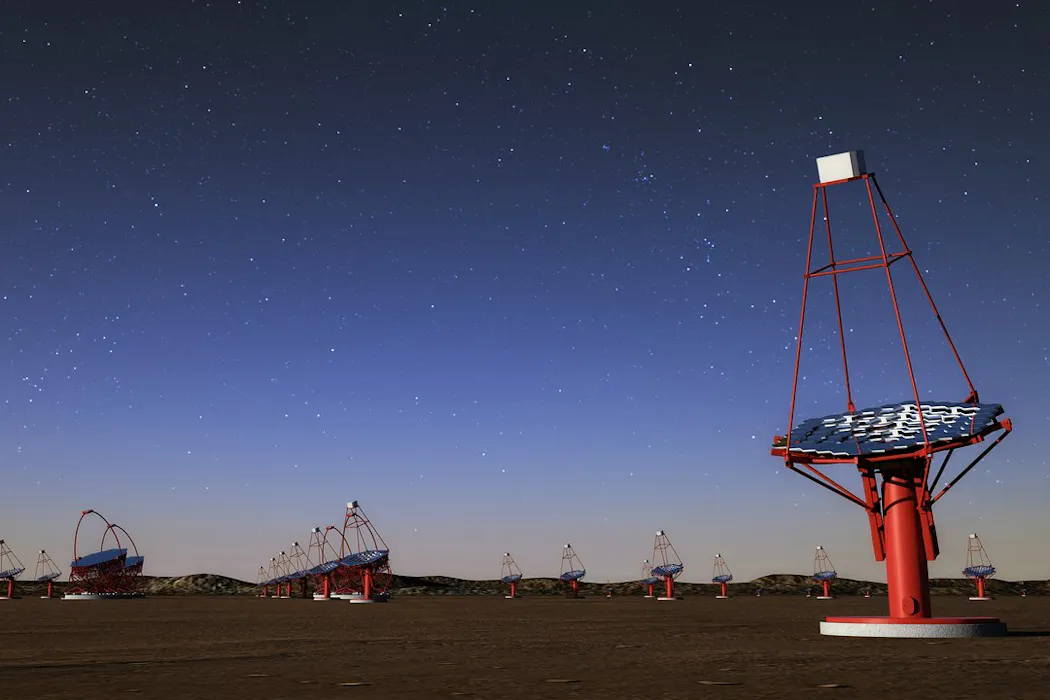
Le projet Giant Radio Array for Neutrino Detector (GRAND), par exemple, qui implique l’installation d’antennes sur 200 kilomètres carrés pour observer l’espace depuis la Terre, a une empreinte carbone estimée à 471 tonnes d’équivalent CO₂. Pour un télescope du réseau Cherenkov, il faut compter encore un peu plus : entre 2 400 tonnes et 2 950 tonnes d’équivalent CO₂.

Fourni par l’auteur
L’empreinte carbone d’OpenAI sur les 88 heures de calcul est peut-être en deçà de ces chiffres, mais, si on les rapporte à la durée des projets, la différence est, littéralement, astronomique. Ces projets sont, en effet, programmés sur vingt et trente ans respectivement. Dans le cas du télescope, 55 % de l’empreinte carbone provient de l’exploitation du télescope pendant trente ans.
Des arbitrages à faire pour une recherche soutenable
À l’heure où la réduction de nos émissions de gaz à effet de serre est supposée être un objectif de l’Union européenne, cette pratique émergente de résolution algorithmique menace la soutenabilité de la recherche théorique, jusqu’à présent l’une des moins émettrices de gaz à effet de serre.
Il faudra peut-être, dans un futur proche, arbitrer entre de telles recherches théoriques « au bulldozer », les recherches en astronomie et tout autre activité de recherche consommatrice de ressources matérielles et d’énergie. Dit autrement, en mathématiques, il faudra peut-être renoncer à la génération de preuves par LLM.
À lire aussi :
Étudier la Terre sans la détruire davantage : comment faire de la recherche bas-carbone ?

Victor Charpenay a reçu des financements du réseau de centres d’excellence ENFIELD, financé par l’Union européenne.
– ref. L’empreinte carbone astronomique des preuves mathématiques d’OpenAI – https://theconversation.com/lempreinte-carbone-astronomique-des-preuves-mathematiques-dopenai-294894
Original source: https://submissions.mil-osi.com/2026/11/12/lempreinte-carbone-astronomique-des-preuves-mathematiques-dopenai-294894/